2021年6月25日 星期五

9.8 View

View 這個物件可以視作是一個虛擬的表格,本身沒有實體的存在,只能透過 Data Dictionary 得知其相關資訊, View 的內容是由一個或多個 Table 所構成,主要的目的是為了增加資料庫的安全性以及簡化程式碼,例如在 emp 這個表格當中,裡面的薪資 (salary) 欄位是一個敏感性資料,那麼就可以建立一個 View ,內容包含了 emp 除了薪資 (salary) 以外的欄位,未來只要授權使用者只能查詢 View 而不直接查詢原始 emp 這個 Table ,這樣就可以用來保護敏感性資料。使用 create view 語法建立 v_emp , v_emp 是沒有包含薪資 (salary) 這個敏感性資料:


除此之外,當我們有一段 SQL 語法,裡面有些運算式或是 join 條件式,那麼也可以把這麼一段語法建立成 View ,之後如果需要撈取這部分的資料,只要簡單的查詢 View 就好,不用再執行一大段 SQL 語法了。例如 DBA 用來查詢 Redo Log 的語法,需要 join v$log 與 v$logfile 才能得到相關訊息:


SQL> select a.group#,b.member,a.bytes/1024/1024 mb,a.status

       from v$log a, v$logfile b 

      where a.group#=b.group#;


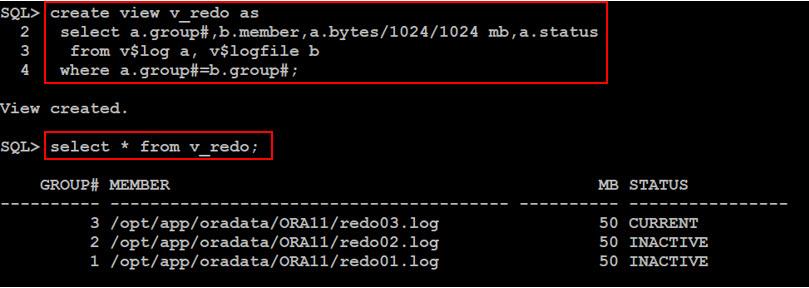
這時就可以把上述語法建立成一個 View ,未來要查詢 Redo Log 相關資訊只需要查詢這個 View 就好,不用再執行這麼複雜的語法了:


雖然 View 簡化了 SQL 語法,但是實際上執行的還是原本複雜的語法,如果 SQL 效能上有問題的話,必須還是要回去優化原本的 SQL 語法,單就 View 本身不會有效能上的改善。


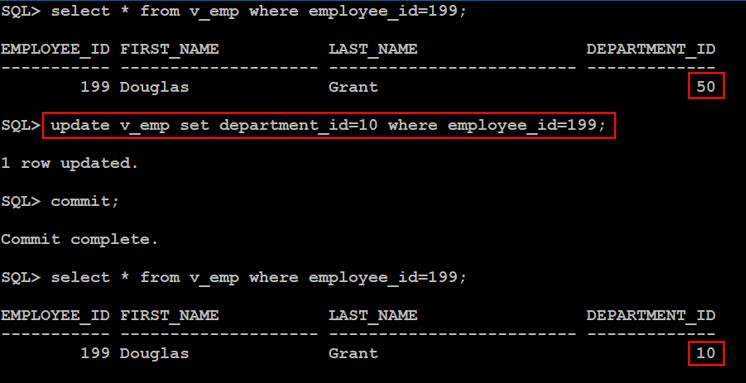
View 本身雖然是一個虛擬的存在,但實際上它的內容是可以有條件被更新的 (Insert 、 Delete 、 Update) ,只要 View 本身可以判斷此欄位是來自於原生哪一個 Table 的欄位,那麼就可以成功更新 View 的資料,在此要注意的是,雖然是對 View 做更新,但實際上是會把資料 Update 回原始的 Table ,例如將 v_emp 這個 View 做 Update ,把 employee_id=199 的 department_id 更新為 10 :


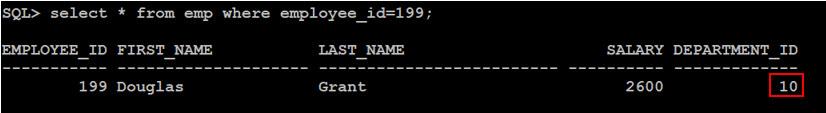
雖然是針對 v_emp 做 update ,但是我們回去查詢原始的 emp 這個 Table ,會發現 employee_id=199 的 department_id 被更新為 10 了:


v_emp 可以被更新是因為這個 View 的內容只是很簡單的來自於單一個 Table emp ,並且沒有經過任何修飾與運算,所以 View 可以很簡單的判斷要去更新哪一個 Table 的哪個欄位,如果是一個比較複雜的 View ,那麼就有可能沒有辦法直接透過 View 更新了,例如建立一個 View 的內容是關於產品的總銷售收入 (earnings) ,這個欄位是由總銷售數量與產品價格所相乘起來:


由於 earnings 欄位是一個經過運算出來的欄位,因此 View 無法判斷此欄位的正確來源,這個時候就沒有辦法對這個 View 的這個欄位做 Update 了:


如果不想讓 View 可以被更新的話,在建立時可以加上 with read only ,這樣 View 就只能唯獨不容許更新了:


除此之外, View 也可以加上 with check option ,用來限制這個 View 的內容只能在某些區間,即便更新了也不可以超出這個範圍,例如建立一個 View 限制 department_id >= 50 ,在有 with check option 的條件下,就不能把 department_id 更新為 50 以下:


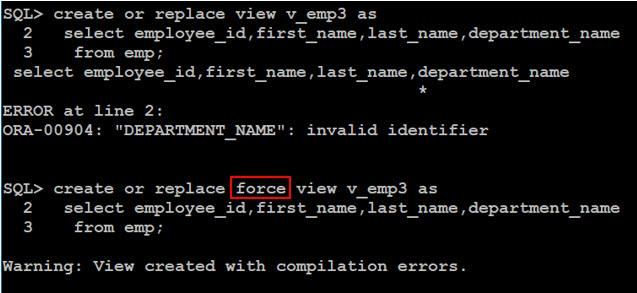
View 本身也是一連串的 SQL 語法所構成,在建立的過程當中會檢查 SQL 語法是否正確,如果語法有問題, View 就無法建立,但是可以透過 force 來強制建立 View ,只不過建立起來後 View 的狀態是 compilation errors 仍然不可用,還是必須解決語法上的問題才行:


要得知 View 的相關資訊可以透過 dba_views 或是 user_views 來查詢:


2021年6月24日 星期四

9.7 Index

接觸過資料庫系統的使用者應該都知道, Index 對於 SQL 效能上有者舉足輕重的影響,為什麼建立 Index 可以提升效能呢 ? 在 Oracle 資料庫中, Index 紀錄了每筆資料的 Rowid , Rowid 表示資料實際存放在 Data File 上的實體位置,以 64 進位的方式所表示,由 object number + file number + block number + row number 所組成。我們使用 SQL 語法來查詢資料,就有如在現實生活中找人一般,假設我們只知道要找的人住在台北市,那麼就只能走遍台北市的所有巷弄才有機會能夠找到這個人,如果我們已經很清楚的知道此人是住在台北市的哪條街哪條巷哪幾號,是不是馬上很快地找到這個人了,同樣的道理, SQL 要是知道此筆資料位在哪個 Data File 哪個 Block 上,那麼也可以很快的就找到這筆資料,這就是為何透過 Index 的查詢會這麼有效率。舉例來說, Index 紀錄著欄位的值與相對應的 Rowid :


假設一個查詢 where 條件查找 22 這筆資料,那麼就會先透過 Index 找到 22 這筆資料並且獲得此筆資料的 Rowid ,既然已經知道了 Rowid ,那麼就可以利用 Rowid 來獲得 Table 上的整筆資料,這個動作我們俗稱為 “回表” 。


Index 在架構上可以分為 B-Tree Index 與 Bitmap Index 兩大類:


  • B-Tree Index

為預設的 Index 架構, Index 呈現出一種樹狀的架構,最頂端的為 Root 、 其次為 Branch , 最底層的為 Leaf Block , Leaf Block 在結構上記錄著 Index Entry Header 、 Key Column Length 、 Key Column Value 以及 Rowid ,也就是前述所提到的欄位值與 Rowid 都是在 Leaf Block 當中。例如一個 Table 有 name 與 NO 兩個欄位,那麼在 NO 這個欄位上建立 Index ,結構上大概會形成這樣:


Index 會將所使用的欄位資料進行排序,原本 NO 欄位的資料沒有順序性,這些資料在 Index 建立的過程中會做好排序並且有順序的存放在 Leaf Block 當中。例如一個 where 條件查找 NO=4 , Index 就會透過 Root 、 Branch 找到 NO=4 所在的 Leaf Block ; 若條件為 NO>=3 ,那麼就會先找到 NO=3 所在的 Leaf Block ,然後再由此 Block 直接向後尋找 4,5,6,7 等 Leaf Block ,此時不會再重複的透過 Root 與 Branch 查找 4,5,6,7。


  • Bitmap Index

Bitmap Index 在結構上也是一個樹狀結構,差別在於 Bitmap Index 的 Leaf Block 紀錄資料的方式與 B-Tree 不同。 B-Tree Index 的 Leaf Block 是直接紀錄資料的數值與 Rowid ,而 Bitmap Index 的 Leaf Block 則是以 1,0 的型態來標示資料所在的相對位置,例如在性別的欄位上建立 Bitmap Index ,那麼結構上就會形成這樣:


由於資料只有 “男” 、 “女” 兩種類別,因此 Bitmap Index 只會產生出兩個 Leaf Block ,藍色的代表資料為 “女” 的 Leaf Block ; 綠色代表資料為 “男” 。產生出 Leaf Block 之後,就會開始來對應原始資料的位置,第一筆資料為 “男” ,所以在綠色表示 “男” 的 Leaf Block 上標示第一筆資料為 1 ; 而藍色表示 “女” 的 Leaf Block 則標示為 0 ,第二筆資料為 “女” ,所以綠色標示為 0 ; 藍色標示為 1 ,第三筆資料為 “男” ,所以綠色標示為 1 ; 藍色標示為 0 … 以此類推。假設一個查詢 where 條件查找性別為 “女” ,那麼透過 Bitmap Index 就會先找到這個藍色代表 “女” 的 Leaf Block ,然後由 Leaf Block 上找出標示為 1 的資料,很快的就可以知道在第 2,7,8 筆資料是性別=”女” 。


一般來說,在欄位資料重複性比較大的時候比較適合建立 Bitmap Index ,原因是在這種情況下所產生的 Leaf Block 較少,查詢起來會比 B-Tree 來的有效率。


Index 在種類上可以建立為 Unique Index 、 Non-Unique Index 、 Composite Index 、 Function-Based Index 與 Partition Index 。 Unique Index 建立的前提是欄位的所有資料必須是唯一值,而 Non-Unique Index 則是我們一般所建立的 Index 沒有特殊要求 ; Composite Index 表示可以使用多個欄位來組成 Index ; Function-Based Index 表示欄位可以經過 Function 函式的轉換之後再存入 Index ,這邊要注意的是, Function-Based Index 只能使用系統內建的 Function 函式,例如 upper 、 lower …等,使用者自行建立的 Function 不可用來建立 Function-Based Index ; Partition Index 表示 Index 本身也可以使用 Partition , 分為 Local Partition Index 與 Global Partition Index , Local Partition Index 表示 Index 的 Partition Key 與 Table 的 Partition Key Column 相同;而 Global Partition Index 則表示 Index 所做的 Partition Key 與 Table 的 Partition Key Column 不同。


建立 Index 使用的是 create index 語法:

SQL> create unique index IX_ID on regions(region_id asc);

    (建立 unique index)

SQL> create index IX_NAME on regions(region_name) tablespace IX_TBS1;

    (建立 Non-unique index)

SQL> create index IX_FNAME on emp(first_name,last_name) tablespace IX_TBS1;

    (建立 composite index)

SQL> create index IX_BNAME on emp (upper(emp_name)) tablespace IX_TBS1;

    (建立 function-based index)

SQL> create bitmap index IX_SEX on emp(sex) tablespace IX_TBS1;

    (建立 bitmap index)

SQL> create index IX_DATE on product(s_date) local;

    (建立 local partition index)


Index 的建立預設是使用 ASC (升冪排序) ,欄位後面不加 asc 的話就是使用預設的升冪排序,如果要使用降冪排序,則在建立的語法當中必須在欄位後面加上 desc ,例如:

SQL> create index IX_PRODID on product(product_id desc);


建立 Index 後面如果不指定 Tablespace 的話,會建立在使用者的預設 Tablespace 下,一般來說都會建立一個獨立的 Tablespace 來存放 Index ,一方面可以避免單一 Tablespace 空間過大,另一方面在維護上將 Tablespace 分門別類也比較好管理。


若是要將 Index 重建,除了將它 drop 掉再重新 create 外,也可以使用 rebuild 語法:

SQL> alter index IX_EMP rebuild;

SQL> alter index IX_EMP rebuild online;


在此需要注意的是,由於 Index 會將資料進行排序,因此在 Index 建立的過程當中 (create / rebuild) 是會造成 Table Lock ,這是為了避免在排序的過程當中又有新的資料進來造成無法排序,如果不希望在 Index 建立的過程當中造成 Table Lock ,那麼就可以加上 online 關鍵字,此時不會造成 Table Lock ,而是會使用 Temporary Table 來記錄資料的異動, Index 將原本的資料排序完之後再來處理這些異動的資料,這種方式雖然不會造成 Table Lock ,但 Index 建立的時間會比原本有 Table Lock 時來得長。


如果不使用某個 Index ,那麼有 drop 、 unusable 與 invisible 三種選項:

SQL> drop index IX_EMP;

    (刪除 index)

SQL> alter index IX_DEP unusable;

    (將 index 設定為 unusable)

SQL> alter index IX_NAME invisible;

    (將 index 設定為 invisible)


將 Index 設定為 unusable 表示要廢棄此 Index 但暫時不刪除,一般都是考慮到使用 drop index 會造成系統額外的負載而又想廢棄此 Index 時,就可以使用 unusable ,等到離峰時間再將此 Index 來 drop 掉,這邊要注意的是一旦 Index 被設定為 unusable ,就不可以再還原為 usable ,想要重新使用的話此 Index 就必須重新 create / rebuild 。


Index 設定為 invisible 是 Oracle 11g 之後的新功能,表示暫時遮蔽掉此 Index , SQL 在查詢過程中不會使用狀態為 invisible 的 Index 。這邊要注意的是,雖然 invisible 的 Index 不會被 SQL 使用,但是資料的異動仍然會持續更新在此 Index 上, invisible 不同於 unusable 的是,如果此 Index 想要再被使用,可以再將它 alter 為 visible ;而 unusable 則不行。


Index 相關的資訊可以由 dba_objects 、 dba_indexes 、 dba_ind_columns 或是 user_objects 、 user_indexes 、 user_ind_columns 來查找,例如要列出當前使用者所有 Table 與其相關 Index 的資訊:


雖然 Index 有助於 SQL 的效能,但也不是建立越多 Index 就越好,因為 Index 上欄位的資料會隨著 Table 上的異動一起更新,會增加 I/O 的負載,另外過多的 Index 也有可能會造成執行計畫的誤判,沒有挑選到最佳的 Index 來使用。 Index 的建立必須考慮到資料的特性以及 SQL 語法的需求來建立,才能夠達到效能優化的目的。


2021年5月31日 星期一

9.6 Constraint

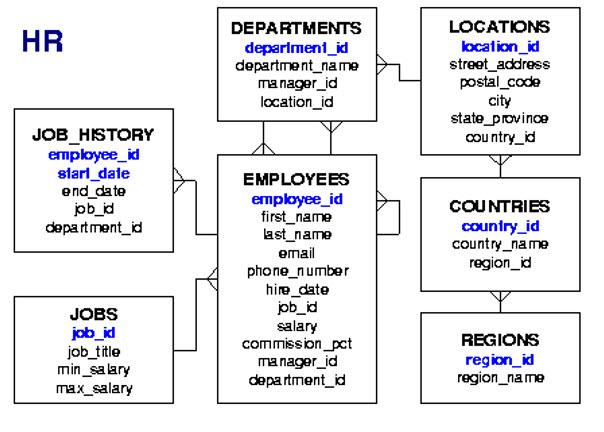
在關聯式資料庫的架構底下,有可能 Table 之間的資料都具有相依性,為了避免 Table 之間的資料錯亂,因此產生了 Constraint 這個東西來約束 Table 的資料,例如在 HR 這個使用者底下,主要的 Table 為 employees ,其它如 departmemts 、 jobs 等 Table 都與其有相關性,例如 employees 的 department_id 這個欄位是關聯到 departments 的 department_id 欄位 、 job_id 欄位則是關聯到 jobs 的 job_id :


Constraint 的種類總共有 Primary Key 、 Foreign Key 、 Not Null 、 Check ,以及 Unique 五種:


  • Primary Key: 

具有 Unique 與 Not Null 的特性, Table 所建立的 Primary Key 可以是單一欄位或者是多個欄位組合起來,作為 Primary Key 的欄位資料必須是唯一值且不可為 Null 。


  • Foreign Key: 

用來參照其它 Table 的欄位資料所用, Foreign Key 所參照的 Table 欄位必須是 Primary Key 或者是具有 Unique 屬性,被參照具有 Primary (Unique) Key 的 Table 我們稱作 Parent Table ;而建立 Foreign Key 用來參照別人的 Table 我們稱作 Child Table 。作為 Foreign Key 欄位的資料必須是所參照 Primary Key (或 Unique Key) 裡面的資料,否則會出現 ORA-02291: integrity constraint violated - parent key not found 的錯誤,例如 sales 具有 Primary Key (prod_id) ,而 sales_items 則是建立 Foreign Key (prod_id) 關聯到 sales:

如果在 sales_itmes insert 一筆 sales 不存在的資料就會報 ORA-02291 錯誤:


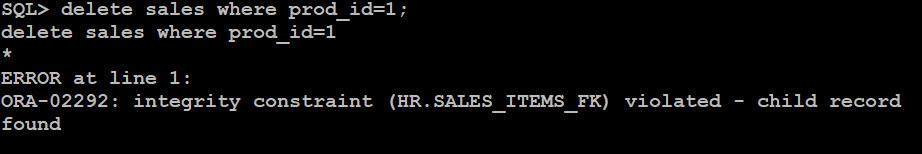
同樣的如果在 Parent Table delete 一筆資料,但此筆資料正存在 Child Table ,此時會報 ORA-02292: integrity constraint violated - child record found:


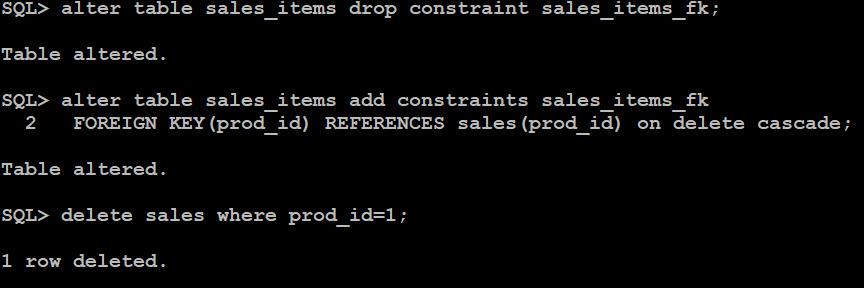
若是 Foreign Key 建立時賦予 on delete cascade 屬性,則 Parent Table 刪除資料的同時也會把 Child Table 相對應的資料刪除,此時不會有 ORA-02292 錯誤:


最後需要注意的是, Child Table 所用來當 Foreign Key 的欄位必須要建立 Index ,否則在 Table 資料的更新過程中,容易因為獲取不到 SSX lock (Share Row-eXclusive: Mode 5) 從而產生等待。上述範例中, SALES_ITEMS 這個 Child Table 的 prod_id 欄位作為 Foreign Key ,此時就必須為 SALES_ITEMS 的 prod_id 建立 Index 。


  • Not Null Constraint:

在 Table 的欄位設定為 Not Null 屬性時,就會幫它加上一個 Not Null Constraint ,表示此欄位的資料不可為 Null 。


  • Check Constraint:

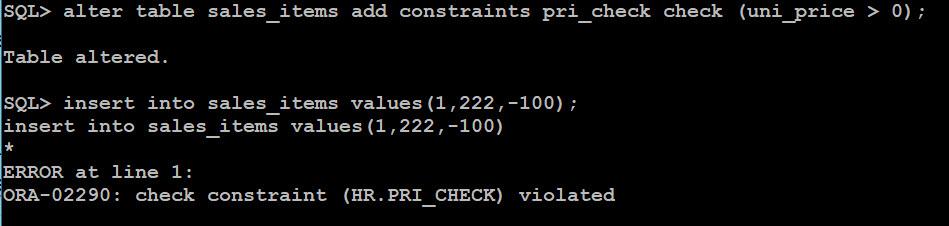
用來檢查 Table 的資料必須符合某些條件,否則不能新增進來。例如限制 sales_items 的 uni_price 欄位值必須大於 0 ,在新增一筆 -100 的資料時便會出現 ORA-02290: check constraint violated 的錯誤:


  • Unique Constraint:

用來檢查欄位的資料是否為唯一值。在建立 Unique Index 的同時會自動添加上 Unique Constraint 。


Constraint 的建立可以在 Create Table 的時候就一併建上,或者是之後用 alter table 的命令來建立:

SQL> CREATE TABLE sales( prod_id NUMBER ,cust_id NUMBER,time_id DATE,

 CONSTRAINT sales_pk PRIMARY KEY(prod_id));

    (在 create table 的時候就建立 primary key)


SQL> alter table sales add constraint c1 unique(prod_id);

    (新建 unique constraint)


SQL> alter table sales_items add constraints sales_items_fk FOREIGN KEY(prod_id) REFERENCES sales(prod_id);

    (新建 foreign key)


除非是在 Table 建立的時候就已經把 Constraint 建好,否則在新增 Constraint 的時候 Table 可能已經有資料了,因此 Constraint 本身的狀態可以分為 enable / disable 與 validate / novalidate 兩種。 


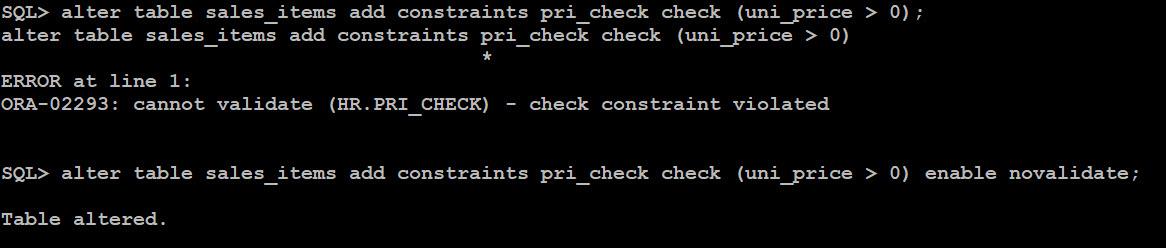
enable / disable 的狀態表示此 Constraint 是否要檢查新增進來的資料, enable 表示檢查新增的資料 ; disable 表示不檢查。 validate / novalidate 表示 Constraint 是否檢查已經存在 Table 上面的資料, validate 表示在 Constraint 新增的同時,檢查 Table 已存在的資料是否符合此 Constraint 的設定,如果已經有資料違反此新增的規則就無法建立,此時必須使用 novalidate 不檢查已存在的資料來新增:


Constraint 建立的預設選項都是 enable validate 。


如果要修改 Constraint 屬性必須使用 alter table 命令來修改:

SQL> alter table sales_items enable novalidate constraint pri_check;

    (將 constraint pri_check 改為 enable novalidate)


SQL> alter table sales_items disable validate constraint sales_items_fk;

    (將 constraint sales_items_fk 改為 disable validate)


要得知 Constraint 的資訊可以從 dba_constraints 或是 user_constraints 來查詢:


其中的 constraint_type 代表:

  • P: Primary Key

  • R: Foreign Key

  • U: Unique Key

  • C: Check 或是 Not Null Constraint


藉由 Constraint 的設定可以確保 Table 之間的資料維持一致性,也可以避免輸入錯誤的資料進到 Table 中,對於關聯式資料庫來說是一個重要的角色。