2022年3月3日 星期四

1. Data Guard 介紹

Oracle Data Guard 就是為 Oracle Database 建立一個 Standby Database 作為備援之用,當 Primary Database 發生問題或損毀時,還有 Standby Database 可以使用。不論是 Primary Database 或者是 Standby Database 都可使用 Single Instance 或者是 RAC ,所以組合起來總共有四種搭配:
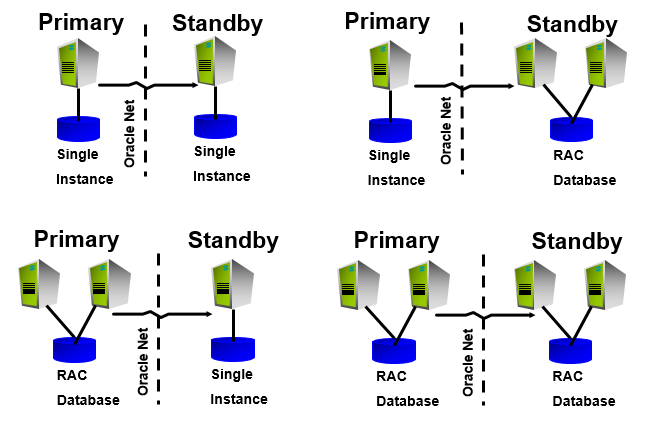

RAC 是由兩台或以上的 Server 來支撐一個資料庫,當其中一個 Server 發生問題還有其它 Server 可以提供服務,而 RAC 的 Server 之間是會放在同一個機房 (Extended RAC 除外) ,因此 RAC 的功用比較像是本地的備援,而 Standby Database 一般都會建立在非本地機房作為異地備援之用,避免本地機房發生不可預期事件造成資料庫損毀並且無法復原時,還有異地的資料庫可以提供緊急使用,在上述的四種搭配當中,對資料庫最好的保護當然就是本地端以及 Standby Database 都使用 RAC ,不過相對的所需付出的硬體成本較高,其次可以選擇本地為 RAC 而 Standby 為 Single Instance ,以節省硬體成本,同時也達到資料庫保護的作用。


Standby Database 不僅僅是只有備援的用途, 它還可以開啟為唯讀模式 (Read Only) ,只有使用 Select 的作業可以將其導到 Standby 端執行,當成報表伺服器使用,或者是資料庫備份也可以由 Standby 端進行備份,這些運用都可以分擔 Primary Database 的負載。


Data Guard 的概念是將 Primary 端的交易日誌 (Redo / Archive Log ) 透過 Oracle Net 傳送到 Standby Database ,然後 Standby 再 Apply 這些交易的異動來達到兩邊資料庫數據的一致, Oracle 資料庫必須為企業版才可以使用此功能,以類型來說可以分為 Physical Standby 與 Logical Standby 兩種 :


  • Physical Standby : 使用 block-for-block basis 的方式,透過接收 Primary 的 Redo Log 並且進行 Redo Apply (Recover) 來達到與 Primary 數據的一致。


  • Logical Standby : 透過接收 Primary 的 Redo Log 並且利用 LogMiner 將 Redo Log 的內容轉換為 SQL 語句,然後在 Standby 執行這些 SQL 語句 (SQL Apply) 來達到與 Primary 數據的一致


這兩者最大的不同是, Physical Standby 使用的是 Redo Apply ,由於是屬於 Block Level ,因此 Physical Standby 不允許與 Primary 產生不一致的現象, Physical Standby 只能開啟為唯讀模式 (Read Only) 避免資料的異動;而 Logical Standby 使用的是 SQL Apply ,此時 Logical Standby 必須是讀寫模式 (Read Write) 才可進行 SQL Apply ,由於是讀寫模式,因此 Logical Standby 的資料是有可能被異動的,具有與 Primary 不一致的風險,所以在資料保護的前提之下,大部分的情況都是選擇使用 Physical Standby 以確保與 Primary 的一致性。


除此之外,有一種比較特殊的模式稱作 Snapshot Standby ,這個是 Oracle 11g 開始的新功能,必須在 Physical Standby 的基礎之下才能轉換為 Snapshot Standby ,原本的 Physical Standby 只能以 Read Only 開啟,不過轉換為 Snapshot Standby 之後便可以 Read Write 模式開啟,主要的用途是讓 Standby Database 可以暫時性的進行讀寫,以實際的行為來驗證 Standby Database 的資料是否正確以及功能是否正常。在轉換為 Snapshot Standby 的時候, Standby Database 會自動 Enable Flashback Database 功能並且建立 Restore Point ,在結束 Standby 的驗證之後將 Snapshot Standby 轉換回 Physical Standby 時,便會使用 Flashback Database 的技術將 Standby 回退到當初建立 Restore Point 的時間點,然後再由這個時間點開始進行 Physical Standby 的資料同步, Snapshot Standby 可以說是多提供了一種 Standby Database 的運用方式。


Oracle 11g 除了 Snapshot Standby 的新功能外,另一個新功能就是 Active Data Guard 。傳統 Physical Standby 的 Redo Apply 是藉由不斷的 Recover 這些交易日誌檔來進行資料同步,而資料庫必須處在 mount 模式下才可以進行 Recover ,如果要將 Standby 開啟為 Read Only ,必須停止 Recover 才能夠開啟,不過這個時候 Standby 的資料就停止在這個時間點,而 Active Data Guard 指的是 Standby 在 Read Only 模式下仍然可以進行 Redo Apply (Recover) 的動作,也就是 Standby 開啟至 Read Only 提供查詢服務時,資料仍然是不斷的在更新的,這對於想充分運用 Standby 的使用者來說無疑是一大福音,當 Standby 使用的是 Active Data Guard 模式,在 v$database 裡面的 open_mode 會顯示為 "READ ONLY WITH APPLY" 。


對於資料保護的強度來說, Data Guard 總共有三種模式,最大保護模式 (Maximum Protection) 、 最高可用性模式 (Maximum Availability) ,以及最高性能模式 (Maximum Performance) :


  • 最大保護模式 (Maximum Protection) : 確保 Primary 與 Standby Database 的資料必定完全相同,而且 Standby 不會有任何的資料遺失,在此模式下當 Primary Database 進行 commit 的動作時, commit 會等到這個交易日誌傳送到 Standby 端,並且 Standby 端必須反饋回 Primary 表示已經收到並確認這個交易日誌,此時 Primary 的 commit 動作才會完成。這個模式的好處是 Standby 的資料不會遺失,壞處是當 Standby 不可用時就無法反饋訊息給 Primary ,此時 Primary 的 commit 動作便會無法完成而發生 Hang 的現象,嚴重時也可能導致 Primary Database Crash 。


  • 最高可用性模式 (Maximum Availability) : Primary Database 進行 commit 的動作時, commit 會等到這個交易日誌傳送到 Standby 端後, commit 的動作才會完成,與 Maximum Protection 不同的是, Maximum Availability 不會等到 Standby 端反饋回來,而是 Primary 主觀的確認交易日誌有傳送到 Standby 端便完成 commit 的動作。這個模式的好處是比 Maximum Protection 稍微有彈性一點,壞處是當 Standby 不可用時, Primary 無法單方面確認交易日誌是否能傳送到 Standby 端時,仍然會影響到 Primary Database 的交易,另外由於此模式是不等 Standby 的反饋訊息,因此雖然 Primary Database 主觀認定交易日誌有傳送,但是 Standby 端有可能沒收到,所以還是有一點點的資料遺失的風險在。


  • 最高性能模式 (Maximum Performance) : 這個是 Data Guard 的預設模式, Primary 進行 commit 的動作不會確認交易日誌是否傳送到 Standby 端, Standby 端也無須反饋收到日誌的訊息,這個模式的好處是整個 Data Guard 機制完全不會影響 Primary Database 的運作,壞處是交易日誌沒有傳送到 Standby 端的話, Standby Database 會有資料遺失的風險。


由於我們建立 Standby Database 主要的目的是在多增加一個資料庫的保護,在這個機制下並不希望會影響原本 Primary Database 的運作,因此多數的情況都是使用預設的 Maximum Performance 模式,雖然此模式會有資料遺失的風險,但相較於 Primary Database 的正常運行, Standby 的重要性還是擺在第二順位的。由於 Maximum Protection 與 Maximum Availability 對於 Standby Database 都有高度的依賴性,因此 Primary 與 Standby 的開關順序就很重要,在這兩個模式下,資料庫開啟的順序必須是 Standby 與 Standby 端的 Listener 先啟動,然後再開啟 Primary ;而資料庫關閉的順序則是要先關閉 Primary 之後再關 Standby ,在 Maximum Performance 下則是兩者之間的開關沒有要求一定的順序。


Data Guard 預設都是 Maximum Performance 模式,如果要使用 Maximum Protection 或 Maximum Availability ,則必須在 Primary 端使用 alter database 更改 :

SQL> alter database set standby database to maximize availability;

     (Data Guard 切換為 Maximum Availability 模式)

SQL> alter database set standby database to maximize protection;

     (Data Guard 切換為 Maximum Protection 模式)

SQL> select protection_mode from v$database;

     (查詢 Data Guard 所使用的模式)


這邊要注意的是, Maximum Performance 不能直接切換為 Maximum Protection ,必須先切換成 Maximum Availability 才能再切換至 Maximum Protection 。


Data Guard 的 Primary Database 與 Standby 兩者的角色可以互相轉換,轉換模式有兩種, Switchover 與 Failover :


  • Switchover : Primary 與 Standby 的角色互換,原本的 Primary Database 轉換為 Standby ,而原本的 Standby 轉換為 Primary ,兩者角色互換後繼續進行資料的同步, Data Guard 的機制不會因為角色的轉換而有所改變。當 Primary Database 需要短暫的進行停機維護時,就可以利用 Switchover 將主庫切換為 Standby 端,等到維護結束後再切換回來。


  • Failover : 這個模式主要是將 Standby Activate 起來變為 Primary ,當 Standby Activate 之後, Data Guard 的機制就被破壞,原本的 Primary 與 Standby 關係就不存在了, Failover 主要的用意在於當 Primary 發生問題並且不可用時,緊急的將 Standby Activate 起來作為 Primary 所用,以確保服務能夠在短時間內恢復。由於 Failover 已經破壞原本 Data Guard 的機制,所以要恢復 Data Guard 的話, Standby 端就必須重建。


資料庫是應用系統存放資料的地方,可以說是整個系統架構下最重要的部分,資料庫的保護顯得相當重要, Data Guard 在實務上已經被廣泛地運用,作為一個 Oracle DBA 必須要相當熟悉這個架構。


2022年2月23日 星期三

10. 管理 RAC Database

RAC Database 是由兩台或以上的 Server 來支撐一個資料庫,每個 Server 都會啟動一個屬於此資料庫的 Instance 且各自獨立,每個 Instance 都擁有屬於自己的 SGA 與 Background Process ,再加上與 Global Service 相關的 Daemon :


這邊複習一下 Oracle 資料庫的組成架構,為 Instance + Database ,對於 RAC Database 來說, Instance 的部分是建構在每一個 RAC 節點上,所以與 Instance 相關的成分是各自獨立的;而 Database 的部分則是 Control File 、 Data File 等結構,這個部分則是共享的並且存放在 Shared Storage 上,比較特殊的是,使用者連線到 RAC 資料庫實際上是連線到 RAC 的某一個 Instance 當中,所以使用者有可能在第一個 Instance 進行交易或是在第二個 Instance 進行交易,因此每個 Instance 都必須要有屬於自己的交易紀錄,所以每個 Instance 都會有一份屬於自己的 Redo Log File ,透過 v$log 與 v$logfile 可以查到各個 Instance 的 Redo Log File :


新增 Redo Log File 必須使用 thread 來指定此 Redo Log 是要新增在哪一個 Instance 上,而刪除 Redo Log File 則只需指定 group number :

SQL> alter database add logfile thread 2 group 6 '+DATA' size 200M;

  (添加 Redo Log 至 thread 2)

SQL> alter database drop logfile group 3;

  (刪除 Redo Log Group 3)


同樣的道理對於 Undo Tablespace 來說,每個 Instance 也都必須設定各自的 Undo Tablespace , Undo Tablespace 則是透過資料庫參數來設定,例如將第二個 Instance 的 Undo Tablespace 設定為 UNDOTBS2_1 :

SQL> alter system set undo_tablespace='UNDOTBS2_1' sid='orcl2';


雖然每個 Instance 都有各自的 Redo / Undo ,但 Redo Log File 與 Undo Tablespace 都必須放置在共享的 Shared Disk 上,因為在執行 Instance / Media Recovery 的時候必須要讀取所有的 Redo / Undo 資訊,如果沒有放置在共享磁碟上,那麼就有可能因為讀取不到所有的 Redo / Undo 資訊造成 Recovery 失敗。


RAC Database 的參數檔 Spfile 必須是共享的,而資料庫參數有些是必須所有的 Instance 的設置都要一樣,有些參數則是每個 Instance 可以設置不同,透過 Spfile 產生出 Pfile 可以發現參數內容與 Single Instance Database 略有不同:


參數當中使用 "*." 代表此參數是所有 Instance 的設置都一樣,不一樣的是 "orcl1." 以及 "orcl2." 代表著此參數於這個 Instance 的設定,例如 " orcl1.undo_tablespace='UNDOTBS1' " 表示 orcl1 這個 Instance 設定的 undo_tablespace 為 UNDOTBS1 ,使用 alter system 更改參數時加上 sid= 來指定更改某一個 Instance 的參數,如果不使用 sid= 或者是 sid='*' 則是所有 Instance 都套用此參數,例如 :

SQL> alter system set local_listener='(ADDRESS=(PROTOCOL=TCP)(HOST=192.168.49.111)(PORT=1521))' sid='orcl1'

  (設定 orcl1 這個 Instance 的 local_listener 參數)

SQL> alter system set remote_listener='grid-scan:1521';

  (設定所有 Instance 的 remote_listener 參數)


在所有的參數當中,有些參數必須所有 Instance 都必須一致而有些參數則是 Instance 之間可以設定不同,例如 compatible 、 control_files 、 db_name 、 db_unique_name …等參數必須所有 Instance 相同; memory_target 、 sga_target …等參數可以每個 Instance 設定不同,大致上來說與 Instance 相關的參數可以個別設定不同,與 Database 相關的參數則是所有 Instance 必須相同,比較特殊的是 thread 、 instance_number 、 undo_tablespace 這幾個參數必須每個 Instance 都不同。


RAC Database 指定 Spfile 的方式可以透過 pfile 於每個 Instance 的 $ORACLE_HOME/dbs 底下設定,例如 initorcl1.ora 的內容設定為 SPFILE='+DATA/orcl/spfileorcl.ora' ,那麼 orcl1 啟動時就會經由 initorcl1.ora 去找到共享的 spfile ,另外一種方式就是設定在 Cluster 裡面,使用 srvctl config database 指令可以查詢目前資料庫於 Cluster 中的設定 :


使用 srvctl 來開啟資料庫時就會由 Cluster 抓取這個設定來開啟,如果要更改 spfile 的設定,則可以使用 srvctl modify database –h 來查詢 srvctl modify 指令需帶入哪個參數來更改。


RAC Database 的啟動與關閉可以透過 sqlplus 或者是 srvctl 來達成,只要是 RAC 其中一個 Instance 啟動就視為此 RAC Database 已經開啟;而 RAC Database 關閉則是要所有的 Instance 都 Shutdown 才視為關閉。使用 sqlplus 操作與一般 single instance 的作法沒有差別,先將其中一個 Instance 開啟後,其它 Instance 再陸續的啟動 :


使用 srvctl 則是經由 Cluster 來發動啟動與關閉的命令 :

$ srvctl start database –d orcl

 (開啟 orcl 資料庫,會啟動所有 Instance)

$ srvctl start instance –i orcl1 –d orcl

 (只啟動 orcl 資料庫的 Instance 1 , orcl1)

$ srvctl stop database –d orcl

 (關閉 orcl 資料庫,會關閉所有 Instance)

$ srvctl stop instance –i orcl2 –d orcl

 (只關閉 orcl 資料庫的 Instance 2 , orcl2)


建議 RAC Database 統一使用 srvctl 指令來操作,管理上較為方便。


RAC Database 於管理上來說,則是多了 Global View (gv$ 開頭的 view) 可供查詢, v$ 的 view 只能查詢到當前 Instance 的資訊,而 gv$ 的 view 則是可以查詢所有 Instance 的訊息,差別在於 gv$ 多了 inst_id 的欄位,經由 inst_id 可以得知其它 Instance 的資訊,例如我們透過 gv$instance 來檢查所有 Instance 的狀態 :


對於 AWR 來說,每個 Instance 都會建立屬於自己的 AWR Snapshot ,建立 AWR Report 可以選擇每個 Instance 獨立產生自己的 AWR Report ,或者是可以建立 RAC Database 整體的 AWR Report 。建立單獨 Instance 的 AWR Report 與一般 Single Instance 無異,需登入此 Instance 後執行 $ORACLE_HOME/rdbms 底下的 awrrpt.sql 來產生,除此之外可以選擇使用 awrrpti.sql ,它會詢問要產出哪一個 Instance 的 AWR Report ,而 awrrpt.sql 則是直接產出當前連線 Instance 的 AWR Report ;若是要產出整體 RAC Database 的 AWR Report ,則是使用 awrgrpt.sql 產出。


RAC Database 的備份透過 RMAN 與備份 Single Instance Database 時的操作差別不大, 在於 RAC Database 可以將 channel 分佈到多個 Instance 上來處理如此而已,例如三個 Instance 各分配一個 channel 來備份 :

RMAN> run {

        allocate channel ch1 type sbt connect='sys/welcome1@orcl1';

        allocate channel ch2 type sbt connect='sys/welcome1@orcl2';

        allocate channel ch3 type sbt connect='sys/welcome1@orcl3';

backup database plus archivelog delete input;

}


RAC Database 在管理上無須想的太複雜,其實也不就多了幾個 Instance 而已,重點還是在於要了解 RAC 本身的架構,相信對 RAC 架構有一定的了解之後,操作 RAC Database 也一定不是什麼難事。


2022年2月14日 星期一

9. Load Balance 與 Failover

RAC 是由多個 Server 所組成,當其中一個節點發生故障時,還有其它的節點可以提供服務,這個特性我們將其稱為 Failover ;當我們透過 SQL*Net 連線到 RAC 資料庫時, RAC 會自動將這些連線平均的分配到每一個擁有此 Database Instance 的節點上,這個特性我們稱作為 Load Balance 。


RAC 資料庫的連線方式可以透過 vip 直接連線或者是使用 SCAN ,透過 vip 連線如果想要達到 Load Balance 的效果,必須把每個節點的 vip 設定到 tnsnames.ora 並使用 LOAD_BALANCE=ON ,這樣系統就會平均將連線分散到每個節點上;如果是使用 SCAN-NAME 連線,那麼就會先去 DNS 查詢此 SCAN-NAME 所對應的 IP ,然後由 SCAN Listener 接收到連線的資訊,最後再將連線平均分配到每個節點上。


RAC 的 Load Balance 可以分為 Client Side Load Balance 與 Server Side Load Balance 兩種:


  • Client Side Load Balance : 透過 tnsnames.ora 的 LOAD_BALANCE=ON 設定所實現,例如:


ORCL=

(DESCRIPTION=

    (ADDRESS_LIST=

      (LOAD_BALANCE=ON)

      (ADDRESS=(PROTOCOL=TCP)(HOST=node1-vip)(PORT=1521))

      (ADDRESS=(PROTOCOL=TCP)(HOST=node2-vip)(PORT=1521)))

    (CONNECT_DATA=(SERVICE_NAME=ORCL)))


這樣連線到 ORCL 時就會隨機使用 node1-vip 或 node2-vip 進行連線,如果不使用 LOAD_BALANCE=ON ,那麼只會先使用第一組 node1-vip 進行連線,同樣的設定也適用於 scan ip :


ORCL=

(DESCRIPTION=

    (ADDRESS_LIST=

      (LOAD_BALANCE=ON)

      (ADDRESS=(PROTOCOL=TCP)(HOST=192.168.49.110)(PORT=1521))

      (ADDRESS=(PROTOCOL=TCP)(HOST=192.168.49.111)(PORT=1521))

      (ADDRESS=(PROTOCOL=TCP)(HOST=192.168.49.112)(PORT=1521)))

    (CONNECT_DATA=(SERVICE_NAME=ORCL)))


192.168.49.110 ~ 112 這三組是 SCAN-NAME 註冊到 DNS 上所對應的三組 IP 。以上兩種設定都可以達到 Client Side Load Balance 的效果。


  • Server Side Load Balance : tnsnames.ora 裡面不使用 LOAD_BALANCE=ON ,而是透過資料庫參數的 remote_listener 來實現,也就是說先連線到某一個節點上,然後再經由 remote_listener 來平均分配連線。 remote_listener 的設定可以使用 vip 或者是 SCAN-NAME ,在 Grid Infrastructure 的架構下, remote_listener 預設都是為 SCAN-NAME 。如果要使用 vip 來達成 Server Side Load Balance ,首先必須於 tnsnames.ora 定義 remote_listener 所對應的 vip 資訊:


LISTENER_REMOTE =

  (ADDRESS_LIST =

    (ADDRESS = (PROTOCOL = TCP)(HOST = node1-vip)(PORT = 1521))

    (ADDRESS = (PROTOCOL = TCP)(HOST = node2-vip)(PORT = 1521)))


定義好之後將參數 remote_listener 設定為此:


SQL> alter system set remote_listener='LISTENER_REMOTE';


設定好之後,資料庫的連線字串就不需要使用 LOAD_BALANCE=ON :


ORCL=

(DESCRIPTION=

    (ADDRESS_LIST=

      (ADDRESS=(PROTOCOL=TCP)(HOST=node1-vip)(PORT=1521))

      (ADDRESS=(PROTOCOL=TCP)(HOST=node2-vip)(PORT=1521)))

    (CONNECT_DATA=(SERVICE_NAME=ORCL)))


如果是使用 SCAN-NAME 來連線,那麼連線字串就簡單使用 SCAN-NAME 再搭配 remote_listener 就可以達到 Server Side Load Balance 的效果:


SQL> alter system set remote_listener='SCAN-NAME:1521'


ORCL=

(DESCRIPTION=

    (ADDRESS_LIST=

      (ADDRESS=(PROTOCOL=TCP)(HOST=SCAN-NAME)(PORT=1521)))

    (CONNECT_DATA=(SERVICE_NAME=ORCL)))


至於 Failover 的類型可以分為 Client-Side Connect Time Failover 、 Transparent Application Failover (TAF) 與 Sever-Side TAF 三種 :


  • Client-Side Connect Time Failover : 在連線的階段進行 Failover ,透過 tnsnames.ora 的 FAILOVER=ON 設定所實現,例如:


ORCL=

(DESCRIPTION=

    (ADDRESS_LIST=

      (FAILOVER=ON)

      (ADDRESS=(PROTOCOL=TCP)(HOST=node1-vip)(PORT=1521))

      (ADDRESS=(PROTOCOL=TCP)(HOST=node2-vip)(PORT=1521)))

    (CONNECT_DATA=(SERVICE_NAME=ORCL)))


這個設定當中由於沒有 LOAD_BALANCE=ON ,所以會優先使用第一個 ip ,也就是 node1-vip 進行連線,由於設定了 FAILOVER=ON ,當 node1-vip 無法連線時,就會自動改用 node2-vip 來嘗試連線。


  • Transparent Application Failover : 已經成功連進資料庫並進行作業的時候,若當前的節點發生問題,則自動將 session 轉移到另一個節點上繼續作業,透過 tnsname.ora 的 FAILOVER_MODE 設定來實現,例如:


ORCL=

(DESCRIPTION=

    (ADDRESS_LIST=

      (LOAD_BALANCE=ON)

      (ADDRESS=(PROTOCOL=TCP)(HOST=node1-vip)(PORT=1521))

      (ADDRESS=(PROTOCOL=TCP)(HOST=node2-vip)(PORT=1521)))

    (CONNECT_DATA=(SERVICE_NAME=ORCL)

    (FAILOVER_MODE =

               (TYPE=SELECT)

               (METHOD=BASIC)

               (RETRIES=180)

               (DELAY=5))))


FAILOVER_MODE 共有四個參數可做設定:


  • TYPE : 可設定為 session 或者是 select 。 session - 當節點發生問題時, Client 必須要重新連線; select – 當節點發生問題時,自動將當前的 session 導向另一個節點,此時連線不會中斷。

  • METHOD : 可設定為 basic 或者是 preconnect 。 basic – 當前節點發生問題時才會連線到另一個節點上。 preconnect – 除了當前節點的連線外,同時也建立 shadow connect 到其它節點上。

  • RETRIES : 用來設定 failover 的重新嘗試次數。

  • DELAY : 用來設定重新嘗試的間隔時間,以秒為單位。


這邊要注意的是,只有在做 select 行為時的 failover 連線才不會中斷,如果是 DML 的行為,那麼當前的 session 就會中斷,必須重新連線才行。


透過 v$session 可以查詢此 session 是否被 failover :


ORCL=

SQL> select username,service_name,failover_method,failover_type

      from v$session where sid = 1170;


USERNAME     SERVICE_NAME    FAILOVER_METHOD    FAILOVER_TYPE

---------------    ---------------------   ---------------------------    -----------------------

  SCOTT          ORCL            BASIC                SESSION


  • Server-Side TAF : 透過 Oracle Service 所實現,當我們建立好一個資料庫時,預設會產生以 db_unique_name 為名稱的 service ,除此之外,我們還可以針對此資料庫建立其它的 service 來使用。在 RAC 架構中,建立額外的 DB Service 可以用來將工作群組化,例如一組四個節點的 RAC ,此時可以建立兩個 Service , Service A 只啟用在 node1 與 node2 、 Service B 則啟用在 node3 與 node4 ,此時所有的交易型作業都使用 Service A 來連線,那麼交易就只會使用到 node1 與 node2 、 批次型的作業則是使用 Service B 連線,則批次作業就只會跑在 node3 與 node4 ,工作群組化的好處是,可以將每個 RAC 節點所需要扮演的角色定義清楚,各司其職,避免一個節點同時執行太多不同種類的作業,增加系統的負擔。


建立 Service 的另一個好處是可以達到 TAF 的效果,例如建立一個 Service C ,那麼此時可以設定 Service C 主要只啟用在 node1 而 node2 則是當備援,當 node1 發生問題時再把 Service C 導向 node2 繼續進行服務。


在 RAC 架構中,以 srvctl 指令來建立 Service ,若是 single instance 的架構,則是使用 dbms_service 來建立。在 RAC 節點為 Administrator Managed 的情況下, Service 可以設定 Preferred Server (將 Service 啟用在哪些節點) 以及 Available Server (將哪些節點作為此 Service 的備援) ,例如建立一個 orcl_job 的 Service :


$ srvctl add service –d orcl –s orcl_job –r node1 –a node2 –e select –z 10 –w 5


-d : 針對哪一個資料庫來建立它的 Service 

-s : Service 名稱,在此為 orcl_job 

-r : Preferred Server

-a : Available Server

-e : TAF failover type ,在此為 select

-z : TAF retry 次數

-w : TAF retry 間隔時間


這邊設定了 Preferred Server 為 node1 、 Available Server 為 node2 ,表示 orcl_job 這個 Service 只運行在 node1 ,當 node1 發生故障時再把 Service 轉移到 node2 進行服務。


在 Policy Managed 的架構下,則是設定此 Service 為 Uniform (Server Pool 中的所有節點都啟用此 Service) 或是 Singleton (只將此 Service 啟用在此 Server Pool 中的一個節點上) ,例如:


$ srvctl add service –d orcl –s orcl_job –g SP1 –c uniform –e select –z 10 –w 5


-g : Server Pool 的名稱,在此為 SP1

-c : 設定 Service 啟用的節點,在此為 uniform


建立好 Service 之後便可透過 srvctl 來操作:

$ srvctl start service –d orcl –s orcl_job

  (開啟 orcl_job 這個 service 服務)

$ srvctl stop service –d orcl –s orcl_job

  (關閉 orcl_job 這個 service 服務)

$ srvctl modify service –d orcl –s orcl_job –i node2 –r

  (將 node2 設定為 orcl_job 這個 service 的 preferred server)

$ srvctl relocate service –d orcl –s orcl_job –i node1 –t node2

  (將 orcl_job 這個 service 從 node1 移轉到 node2)

$ srvctl remove service –d orcl –s orcl_job

  (刪除 orcl_job 這個 service)


Load Balance 與 Failover 這兩個功能是 RAC 架構下的特性,不過 Load Balance 功能算是一個雙面刃,好處是可以將連線平均分配到所有節點上達到均衡負載的效果,缺點是資料庫容易產生 GC (Global Cache) 的等待事件,有時候 GC 事件對於效能來說會產生重大影響,比較好的做法是使用 Service ,利用 Service 將作業分配到指定的節點上運行,用指定節點的方式來運行不僅可以達到負載平衡的目的,同時由於作業類型的不同也可以避免 GC 等待事件的產生,再加上 Service 也具有 TAF 的特性,不用擔心會單點故障,使用 Service 可以說是一舉數得。