2022年8月2日 星期二

3. Extract

OGG Extract 可分為兩種功能,一種為 Capture ,負責抽取 Source 端的交易數據並產生出 Trail File 來存放這些交易數據;另一種為 Pump ,負責將 Trail File 傳送到 Target 端,所以我們在 Source 設定 OGG 時,一般都會設定兩個 Extract 為一組,一個做為 Capture 另一個作為 Pump 。


在 Source 設定 Extract 之前,資料庫必須先啟用 Supplemental Log 與 Force Logging :

$ sqlplus / as sysdba

SQL> alter database force logging;

SQL> alter database add supplemental log data;


在資料庫層級啟用 Supplemental Log 之後,接下來要為所要同步的 Table 添加 Supplemental Log ,例如我們要同步 HR 這個使用者底下所有的 Table ,那麼就需要將 HR 底下所有的 Table 都添加 Supplemental Log ,透過 GGSCI 執行 add trandata 來添加 :

$ ./ggsci

GGSCI> dblogin userid ogg, password ogg

GGSCI> add trandata hr.*


add trandata 會於資料庫幫每個 Table 建立 Supplemental Log Group ,由 dba_log_groups 可以查詢,其中 log_group_name 為 GGS 開頭的就是 add trandata 所建立的 :
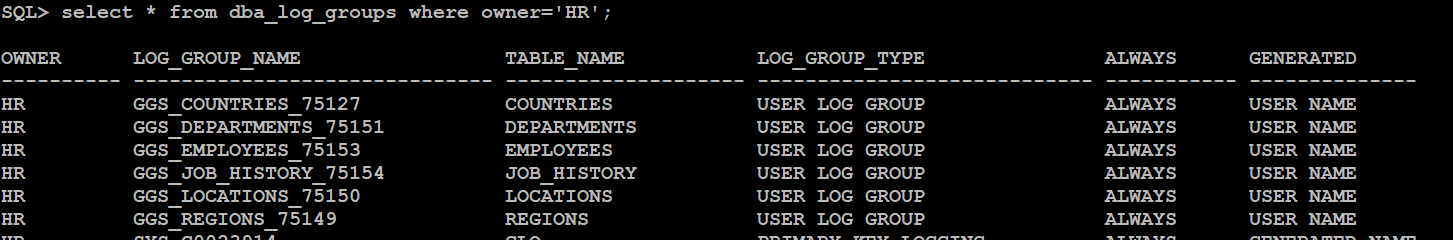

add trandata 是為 Table 添加 Supplemental Log ,為 Table Level ,另一種方式是使用 add schematrandata ,從 Schema Level 直接為整個 Schema 添加 Supplemental Log :

$ ./ggsci

GGSCI> dblogin userid ogg, password ogg

GGSCI> add schematrandata hr


add schematrandata 為 Schema Level ,此時並不會於 dba_log_groups 建立 log group ,必須透過下列指令查詢某個 Table 是否有 Supplemental Log ,例如查詢 REGIONS 這個 Table 是否有 Supplemental Log :
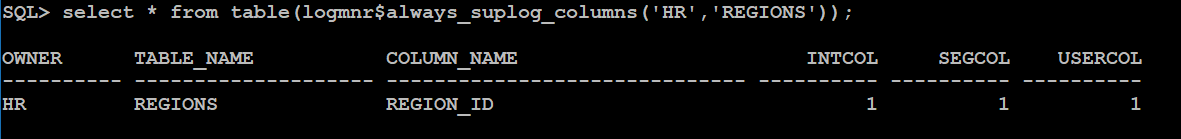
SQL> select * from table(logmnr$always_suplog_columns('HR','REGIONS'));


透過 GGSCI 也可以使用 info 指令來確認是否有 Supplemental Log :

$ ./ggsci

GGSCI> dblogin userid ogg, password ogg

GGSCI> info trandata hr.*

GGSCI> info schematrandata hr


add trandata 主要的目的在於能夠讓交易日誌 (Redo / Archive Log) 紀錄 Table 異動前後的數值,如果缺乏這項數據,那麼在將來開啟同步之後就很有可能會遇到 ORA-04031 no data found 的錯誤導致 Table 無法同步。


在做好前置準備作業之後,接下來就可以幫 Source 資料庫設定 Capture 。作為 Capture 的 Extract 有兩種模式可以使用,一種為 Classic Extract ,另一種則為 Integrated Extract 。


Classic Extract 是 OGG 這項產品原生的模式, Extract 為一個外掛的 Process ,由 OGG 軟體本身使用 API 去解析 Redo / Archive Log 來抽取交易資料,建立 Extract 前首先需要編輯參數如下,例如建立名稱為 EXT1 的 Extract :

$ ./ggsci

GGSCI> edit param ext1


EXTRACT EXT1

SETENV (NLS_LANG="AMERICAN_AMERICA.AL32UTF8")

SETENV (ORACLE_SID="ORCL")

SETENV (ORACLE_HOME="/user1/OraHome/db")


USERID ogg, PASSWORD ogg

TRANLOGOPTIONS DBLOGREADER, DBLOGREADERBUFSIZE 2597152, ASMBUFSIZE 28000

EXTTRAIL ./dirdat/E1

DISCARDFILE ./dirrpt/ext1.dsc, PURGE, MEGABYTES 100


GETUPDATEBEFORES

NOCOMPRESSDELETES

NOCOMPRESSUPDATES


CACHEMGR CACHESIZE 2G, CACHEDIRECTORY ./dirtmp


DYNAMICRESOLUTION

FETCHOPTIONS FETCHPKUPDATECOLS

EOFDELAYCSECS 10


DDL INCLUDE MAPPED

DDLOPTIONS ADDTRANDATA retryop retrydelay 10 maxretries 10


TABLE HR.*;


參數說明如下:

  • TRANLOGOPTIONS DBLOGREADER : 如果資料庫使用的是 ASM ,那麼就需要透過 OGG 所提供的 DBLOGREADER 這個 API 去讀取 ASM 的資料,如果不是使用 ASM ,那麼這個參數可以不用設定。 DBLOGREADER 為 OGG 11g 之後所提供的 API ,早期要抓取放置在 ASM 的 Archive Log 必須使用 Tnsnames (sys@ASM) ,有了這個 API 之後就方便多了。

  • GETUPDATEBEFORES : Extract 抓取 update 語法的 Before Image。

  • NOCOMPRESSDELETES / NOCOMPRESSUPDATES : 設定 Extract 抓取 delete 與 update 語法時要寫入多少資訊進入 Trail , COMPRESSDELETES / COMPRESSUPDATES 表示只寫入 PK 與異動欄位的資訊進入 Trail ,而 NOCOMPRESSDELETES / NOCOMPRESSUPDATES 表示將所有欄位的資訊都寫入 Trail 。

  • CACHEMGR : 設定這個 Extract Process 會用到作業系統多少記憶體,如果不設定的話,那麼 Extract 會盡可能地使用可用的記憶體,這樣會有將系統記憶體吃光的風險,建議 Extract 都必須限制這個數值。

  • DYNAMICRESOLUTION : 解析 schema.* 的物件時,只有在第一次啟動的時候去 Data Dictionary 解析 schema.* 底下有哪些 Table ,不用每次都去 Data Dictionary 解析。

  • DDL INCLUDE MAPPED : 同步 DDL , INCLUDE MAPPED 表示只有需要同步 Table 的 DDL 才需要抓取。

  • DDLOPTIONS ADDTRANDATA : 在有設定 DDL 的情況之下,如果有 Create 新的 Table 的時候,自動將這個 Table 執行 add trandata 的動作,避免新 Table 缺乏 Supplemental Log 。

  • TABLE : 設定要同步的 Table , HR.* 表示要抓取 HR 底下所有 Table 的交易資訊。


在編輯完參數之後,如果要同步 DDL , Classic Extract 必須再做額外的設定才能夠同步 DDL , DDL 的抓取是透過 Trigger 來達成,於 OGG Home 目錄底下執行下列腳本來建立 DDL 所用的 Trigger :

$ sqlplus / as sysdba

SQL> @sequence.sql

SQL> @marker_setup.sql

SQL> @ddl_setup.sql   (輸入 initialsetup )

SQL> @role_setup.sql

SQL> GRANT GGS_GGSUSER_ROLE TO ogg;

SQL> @ddl_enable.sql

--- optional (將資訊 pin 入 shared pool 提高效能 ) ---

SQL> @?/rdbms/admin/dbmspool

SQL> @ddl_pin.sql   (輸入 ogg 使用者的名稱)


執行完畢後便會建立名為 GGS_DDL_TRIGGER_BEFORE 的 Trigger 。


參數編輯完成後,就可以添加 Extract Group :

GGSCI> add extract ext1, tranlog, threads 2, begin now 

(添加名為 ext1 的 extract, begin now 從現在開始抽取資料, threads 2 表示 RAC 資料庫有兩個節點,如果不是 RAC DB ,則不需要加 threads 2)

GGSCI> add exttrail ./dirdat/E1, extract ext1, megabytes 100

(設定 ext1 的 trail file 名稱為 E1 開頭,每個 trail 大小為 100 MB)


Integrated Extract 為 Oracle 改進之後的 Extract 模式,不同於 Classic Extract 的外掛模式, Integrated 使用的是 Oracle 資料庫內部的機制,於 Oracle 資料庫中啟動一個 Process ,透過 Logminer 來解析 Redo / Archive Log 。 Integrated Extract 的參數與 Classic Extract 大同小異,差別在於多了 INTEGRATEDPARAMS 這個參數 :


EXTRACT EXT1

SETENV (NLS_LANG="AMERICAN_AMERICA.AL32UTF8")

SETENV (ORACLE_SID="ORCL")

SETENV (ORACLE_HOME="/user1/OraHome/db")


USERID ogg, PASSWORD ogg

EXTTRAIL ./dirdat/E1

DISCARDFILE ./dirrpt/ext1.dsc, PURGE, MEGABYTES 100


LOGALLSUPCOLS

UPDATERECORDFORMAT FULL


CACHEMGR CACHESIZE 2G, CACHEDIRECTORY ./dirtmp


TRANLOGOPTIONS INTEGRATEDPARAMS (MAX_SGA_SIZE 2048, PARALLELISM 2)


DYNAMICRESOLUTION

FETCHOPTIONS FETCHPKUPDATECOLS

EOFDELAYCSECS 10


DDL INCLUDE MAPPED

DDLOPTIONS ADDTRANDATA retryop retrydelay 10 maxretries 10


TABLE HR.*;


  • INTEGRATEDPARAMS 所設定的 MAX_SGA_SIZE 對應到資料庫指的是 Stream Pool Size ,並非是 SGA Size ,單位為 MB。

  • LOGALLSUPCOLS : 紀錄 delete / update 異動的所有欄位的資訊以及 Before Image ,相當於 (GETUPDATEBEFORES + NOCOMPRESSDELETES + NOCOMPRESSUPDATES) 。

  • UPDATERECORDFORMAT FULL : 抓取 update 的異動時,同時記錄 Before 以及 After Image 。


編輯完參數之後,同樣的添加 Integrated Extract ,由於 Integrated Extract 使用的是 Oracle 資料庫的 Process ,因此必須先於資料庫中執行 Register 的動作,這個動作的目的是於資料庫添加此 Extract 的起始 SCN :

GGSCI> dblogin userid ogg, password ogg

GGSCI> register extract ext1 database


然後再使用 Integrated 選項來建立 Integrated Extract :

GGSCI> add extract ext1, integrated tranlog, begin now


比起 Classic Extract , Integrated Extract 的優點在於,使用的是 Oracle 資料庫的 Process ,可以設定多個 Threads 來加快 Capture 的速度 (由 INTEGRATEDPARAMS 的 PARALLELISM 設定) ,而 Classic Extract 外掛只能是單線程抽取,除此之外, Integrated Extract 不需要做額外的設定便可以抽取存放在 ASM 的 Redo / Archive Log ,以及 DDL 的抓取也無須透過 Trigger 來達成。


設定完 Capture Extract 之後, Pump 就相對的單純, Pump 只是把 Trail File 送到 Target 端而已,所以在參數檔裡面需要設定 Target 端的 IP 、 Port 以及 Target 端的 Trail File 名稱 :

$ ./ggsci

GGSCI> edit param pump1


EXTRACT PUMP1

SETENV (NLS_LANG="AMERICAN_AMERICA.AL32UTF8")

SETENV (ORACLE_SID="ORCL")

SETENV (ORACLE_HOME="/user1/OraHome/db")

RMTHOST 192.168.49.20 , MGRPORT 7809

RMTTRAIL ./dirdat/R1

PASSTHRU


TABLE HR.*;


  • RMTHOST : 設定 Target 端的 IP 與 MGR PORT 。

  • RMTTRAIL : 設定 Target 端的 Trail 名稱,以 R1 開頭。

  • PASSTHRU : 功能與 DYNAMICRESOLUTION 相同, 不去 Data Dictionary 解析 HR.* 有哪些物件,直接使用 Trail File 中所記錄的物件名稱。


參數設定完之後,建立 Pump Group :

GGSCI> add extract pump1, exttrailsource ./dirdat/E1

(設定要傳送 E1 開頭的 Trail)

GGSCI> add rmttrail ./dirdat/R1, extract pump1, megabytes 100

(設定 Target 端的 Trail 為 R1 開頭,每個檔案 100MB)


最後開啟 Extract 與 Pump ,便完成了 Source 端的 Extract 設定。

GGSCI> start extract ext1

GGSCI> start extract pump1

GGSCI> info all


2022年7月6日 星期三

2. Golden Gate 安裝與前置設定

Oracle Golden Gate 是一個輕量軟體,早期在 OGG 12c 的版本之前,軟體的安裝只不過是把下載下來的軟體解壓縮就可以使用了,值得注意的是,在 OGG 12c 之前的軟體種類區分的非常細,例如要使用 OGG 11g 同步在 Linux上面的 Oracle 10g 的資料庫就必須下載 OGG 11g for Oracle 10g On Linux ,如果是 Oracle 9i 的資料庫就必須下載 OGG 11g for Oracle 9i On Linux :


到了 OGG 12c 的版本之後就沒有區分到這麼細了,軟體只有區分 for 不同的資料庫以及作業系統平台,此外,對於 OGG 12c for Oracle 來說,軟體的安裝必須使用 runInstaller ,比起以往只需要解壓縮, runInstaller 是不是讓 OGG 覺得有 "安裝" 的感覺呢 ?  使用 runInstaller 安裝 OGG ,預設需要使用 XWindows 開啟圖型介面進行安裝,例如安裝 OGG 12c , OGG 12c 可以支援 Oracle 11g 與 12c 的版本,因此安裝一開始必須選擇此次 OGG 是要搭配 Oracle 11g 或 12c 來使用 :


接下來就是設定軟體安裝位置然後就開始進行安裝 :


雖然是 runInstaller 的安裝,不過實際上所做的事也只不過是把軟體解壓縮回來而已,安裝的過程是可以不需要使用圖型介面的,我們只需要編輯 response file 來設定幾個簡單的參數,就可以使用 Silent Mode 來安裝, response file 在 OGG 軟體的 response 目錄下已經有現成的範本 oggcore.rsp ,只需要為 oggcore.rsp 填入幾個參數就完成 response file 的設定 :

oracle.install.responseFileVersion=/oracle/install/rspfmt_ogginstall_response_schema_v12_1_2       (軟體範本的設定,無須改動)

INSTALL_OPTION=ORA11g   (ORA11g 表示 OGG for Oracle 11g) 

SOFTWARE_LOCATION=/u01/app/ogg   (設定 OGG 軟體安裝位置)

START_MANAGER=            (無須設定)

MANAGER_PORT=             (無須設定)

DATABASE_LOCATION=       (無須設定)

INVENTORY_LOCATION=/opt/app/oraInventory

UNIX_GROUP_NAME=oinstall


編輯完 response file 之後就可以使用 Silent Mode 進行安裝 :

$ ./runInstaller –silent –responsefile oggcore.rsp


安裝完成後必須設定環境變數 LD_LIBRARY_PATH 才可以進入 ggsci ,否則會出現找不到 library 的錯誤, 如果是 OGG 19c 之後的版本需要再設定環境變數 GG_HOME :

$ export GG_HOME=/u01/app/ogg

$ export LD_LIBRARY_PATH=$ORACLE_HOME/lib:$GG_HOME:$GG_HOME/lib


最後進入 ggsci 執行 create subdirs 建立目錄後,完成安裝 :

$ ./ggsci

GGSCI> create subdirs


安裝完成後的第一件事就是將 MGR 啟動,進入 ggsci 編輯 MGR 參數 :

$ ./ggsci

GGSCI> edit param mgr


MGR 參數如下 :

PORT 7809

DYNAMICPORTLIST 9101-9121

PURGEOLDEXTRACTS ./dirdat/*, usecheckpoints, minkeepfiles 10

LAGREPORTHOURS 1

LAGINFOMINUTES 30

LAGCRITICALMINUTES 45


PORT : 設定 PORT Number 為 7809 。

DYNAMICPORTLIST : 設定 PORT Range 為 9101-9121 ,在 Source 與 Target 中間有防火牆需要開通時,才需要使用這個設定。

PURGEOLDEXTRACTS : 設定自動刪除 Trail File ,以 check point 為基準,在 Trail 被使用之後進行刪除,最少保留 10 個檔就好。

LAGREPORTHOURS : 設定為 1 表示每隔 1 小時檢查同步有無 Lag 。

LAGINFOMINUTES : 設定為 30 表示當 Lag 達到 30 分鐘以上就將此延遲記錄寫入 error log 。

LAGCRITICALMINUTES : 設定為 45 表示當 Lag 達到 45 分鐘以上就將此記錄視為告警並寫入 error log 。


完成參數設定後就可以啟動 MGR ,完成初步 OGG 的設定 :

$ ./ggsci

GGSCI> start mgr


如果是 Windows 平台,可以把 MGR 的啟動加入到 Windows 服務當中,於 GG_HOME 底下執行 :

C:\GGS>  Install AddService AddEvents


接下來在 Oracle 資料庫當中必須建立一個給 OGG 所用的專屬使用者並賦予相關權限 :

SQL> create tablespace ogg datafile '/u01/oradata/ogg.dbf' size 500M;

SQL> create user ogg identified by ogg default tablespace ogg;

SQL> exec dbms_streams_auth.grant_admin_privilege('OGG');(10g 之前使用)

SQL> exec dbms_goldengate_auth.grant_admin_privilege('OGG');(11g 之後使用)

SQL> grant dba to ogg;  (直接授予 dba 權限,或是授予以下權限)

SQL> grant create any table to ogg;

      grant create any view to ogg;

      grant create any procedure to ogg;

      grant create any sequence to ogg;

      grant create any index to ogg;

      grant create any trigger to ogg;


建立完使用者之後,使用 ggsci 建立 OGG 的 check point table :

GGSCI> dblogin userid ogg, password ogg

GGSCI> add checkpointtable ogg.ggschkpt


對於 Oracle 11g 之後的資料庫版本,需要打開參數 enable_goldengate_replication :

SQL> alter system set enable_goldengate_replication=true;


在一切準備就緒後,接下來就可以開始來設定 OGG 的同步機制。